
책 이미지

eBook 미리보기
책 정보
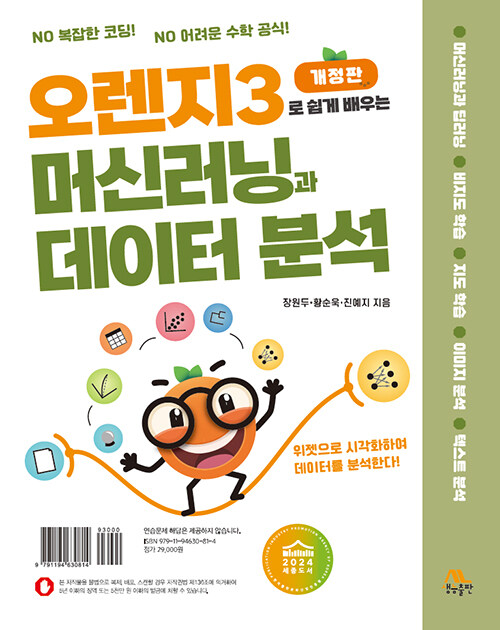
· 제목 : 오렌지로 쉽게 배우는 머신러닝과 데이터 분석
· 분류 : 국내도서 > 컴퓨터/모바일 > 컴퓨터 공학 > 자료구조/알고리즘
· ISBN : 9791192932514
· 쪽수 : 396쪽
· 출판일 : 2024-02-14
· 분류 : 국내도서 > 컴퓨터/모바일 > 컴퓨터 공학 > 자료구조/알고리즘
· ISBN : 9791192932514
· 쪽수 : 396쪽
· 출판일 : 2024-02-14
책 소개
인공지능은 어느새 우리의 삶에 매우 밀접하게 자리 잡았다. 많은 학생들이 인공지능 모델을 만들고 일상 속 다양한 데이터를 분석하고 싶어 하지만, 대부분의 AI 모델이 파이썬과 같은 프로그래밍 언어로 개발된다...
인공지능은 어느새 우리의 삶에 매우 밀접하게 자리 잡았다. 많은 학생들이 인공지능 모델을 만들고 일상 속 다양한 데이터를 분석하고 싶어 하지만, 대부분의 AI 모델이 파이썬과 같은 프로그래밍 언어로 개발된다는 것은 학생들이 인공지능을 배우기로 결심하는 데에 큰 걸림돌이 되곤 한다. 파이썬, R 등을 사용하는 기존의 학습 과정에서는 텍스트 기반의 코딩 언어에 적응하기 위한 시간이 제법 필요하다. 특히, 컴퓨터 관련 전공이 아닌 학생들에게는 텍스트 기반의 코딩을 익히는 것 자체도 어려운 일이 될 수 있다.
이 책에서 소개하는 오렌지는 위젯을 드래그 앤 드롭하는 비주얼 코딩 방식을 가지고 있어, 이를 활용하면 복잡한 텍스트 코딩 없이도 머신러닝 기법을 활용하여 데이터를 쉽게 분석할 수 있다. 파이썬의 머신러닝 패키지인 scikit-learn 라이브러리를 내부적으로 사용하기 때문에 다른 데이터 분석 소프트웨어에 비해 자유도도 매우 높은 편이다.
하지만 기존의 오렌지 관련 책들은 주로 프로그램의 기능을 익히는 데 집중하거나 몇 개의 실습을 수행하는 정도에 그쳐, 머신러닝과 데이터 분석을 하고자 하는 연구자나 학생들에게는 다소 아쉬운 부분이 있었다. 반면, 이 책은 코딩을 전혀 모르는 상태에서도 15주간의 짧은 시간 동안 머신러닝과 데이터 분석을 전반적으로 학습할 수 있다는 큰 장점이 있다.
시간이 많이 소요되는 코딩 과정이 생략되기 때문에, 머신러닝 모델을 활용하는 방법에 좀 더 집중하여 공부할 수 있다. 다양한 예제를 통해 머신러닝의 주요 개념과 데이터를 실제로 분석해 가는 과정을 차근차근 경험할 수 있으며, 스스로의 힘으로 다양한 데이터들을 쉽고 빠르게 분석하는 능력을 갖출 수 있다.
이 책에서 소개하는 오렌지는 위젯을 드래그 앤 드롭하는 비주얼 코딩 방식을 가지고 있어, 이를 활용하면 복잡한 텍스트 코딩 없이도 머신러닝 기법을 활용하여 데이터를 쉽게 분석할 수 있다. 파이썬의 머신러닝 패키지인 scikit-learn 라이브러리를 내부적으로 사용하기 때문에 다른 데이터 분석 소프트웨어에 비해 자유도도 매우 높은 편이다.
하지만 기존의 오렌지 관련 책들은 주로 프로그램의 기능을 익히는 데 집중하거나 몇 개의 실습을 수행하는 정도에 그쳐, 머신러닝과 데이터 분석을 하고자 하는 연구자나 학생들에게는 다소 아쉬운 부분이 있었다. 반면, 이 책은 코딩을 전혀 모르는 상태에서도 15주간의 짧은 시간 동안 머신러닝과 데이터 분석을 전반적으로 학습할 수 있다는 큰 장점이 있다.
시간이 많이 소요되는 코딩 과정이 생략되기 때문에, 머신러닝 모델을 활용하는 방법에 좀 더 집중하여 공부할 수 있다. 다양한 예제를 통해 머신러닝의 주요 개념과 데이터를 실제로 분석해 가는 과정을 차근차근 경험할 수 있으며, 스스로의 힘으로 다양한 데이터들을 쉽고 빠르게 분석하는 능력을 갖출 수 있다.
목차
CHAPTER 01 오렌지, 노코딩, 머신러닝
1.1 노코딩 데이터 분석과 오렌지
1.2 인공지능 개념 잡기
1.3 설치 방법
1.4 화면 구성
1.5 위젯
연습문제
CHAPTER 02 오렌지 기초와 기초 통계 분석
2.1 꽃의 종류별 특징 조사(오렌지의 기초 통계 위젯)
2.2 수강 학생들의 분포를 분석해 보자(피벗 테이블)
연습문제
CHAPTER 03 데이터 시각화
3.1 음주운전을 가장 많이 하는 시간대는 언제일까?(히스토그램)
3.2 와인은 품종에 따라 성분 차이가 있을까?(막대그래프와 Box plot)
3.3 전복도 나이를 먹을까?(산점도와 상관계수)
3.4. 타이타닉 호의 생존자 데이터 분석(Mosaic Display)
연습문제
CHAPTER 04 데이터 전처리
4.1 우리나라에서 가장 더운 도시는?(Impute)
4.2 전기자동차가 가장 활성화된 지역을 찾아보자(Melt)
4.3 보이스피싱은 줄어들고 있을까?(Feature Constructor)
4.4 감기에 제일 많이 걸리는 지역은 어디?(Merge Data, Concatenate)
연습문제
CHAPTER 05 비지도 학습과 데이터 분석
5.1 비지도 학습이란?
5.2 비슷한 성적 패턴을 가진 학생들을 찾아보자(계층적 군집 분류)
5.3 동물원의 동물들을 비슷한 동물끼리 모아보자(K-평균 알고리즘)
5.4 이번 겨울에 방문할 유럽 스키장은 어디?(자기조직화 지도)
5.5 재무 데이터로 우량 기업을 찾아보자(주성분 분석)
연습문제
CHAPTER 06 지도 학습과 데이터 분류
6.1 지도 학습이란?
6.2 주택 가격을 예측해 보자(회귀분석)
6.3 건강검진 데이터로 흡연 여부를 알 수 있을까?(로지스틱 회귀분석과 나이브 베이즈)
6.4 이번 펀딩은 성공할 수 있을까?(K-NN, 의사결정 트리, 랜덤 포레스트)
6.5 심장병이 있는지 예측해 보자(서포트 벡터 머신과 인공신경망)
연습문제
CHAPTER 07 딥러닝과 이미지 분류
7.1 사진 데이터와 딥러닝
7.2 오렌지와 이미지 데이터
7.3 이 꽃의 이름은?(이미지 임베딩과 합성곱 신경망)
7.4 내 컴퓨터의 사진을 정리해 보자(이미지와 비지도 학습)
7.5 차량 종류를 분류해 보자(이미지 학습 응용 (1))
7.6 반려동물의 표정을 분류해 보자(이미지 학습 응용 (2))
연습문제
CHAPTER 08 자연어 처리
8.1 자연어 처리란?
8.2 미국 대선후보들이 가장 많이 쓴 단어는?(워드 클라우드)
8.3 스팸 메일을 자동으로 분류해 보자(자연어 처리 + 머신러닝)
8.4 이 상품을 좋아하는 사람은 얼마나 될까?(텍스트 감성 분석)
8.5 오늘 나온 뉴스 기사의 중심 키워드는?(동시 출현 네트워크)
연습문제
CHAPTER 09 시계열 데이터 분석
9.1 시계열 데이터란?
9.2 주가 정보를 시각화해 보자(시계열 데이터 시각화)
9.3 다음 달 판매량은 얼마일까?(시계열 예측 모델-ARIMA)
9.4 시대별, 나라별 기대수명과 GDP(시각화 지도)
연습문제
1.1 노코딩 데이터 분석과 오렌지
1.2 인공지능 개념 잡기
1.3 설치 방법
1.4 화면 구성
1.5 위젯
연습문제
CHAPTER 02 오렌지 기초와 기초 통계 분석
2.1 꽃의 종류별 특징 조사(오렌지의 기초 통계 위젯)
2.2 수강 학생들의 분포를 분석해 보자(피벗 테이블)
연습문제
CHAPTER 03 데이터 시각화
3.1 음주운전을 가장 많이 하는 시간대는 언제일까?(히스토그램)
3.2 와인은 품종에 따라 성분 차이가 있을까?(막대그래프와 Box plot)
3.3 전복도 나이를 먹을까?(산점도와 상관계수)
3.4. 타이타닉 호의 생존자 데이터 분석(Mosaic Display)
연습문제
CHAPTER 04 데이터 전처리
4.1 우리나라에서 가장 더운 도시는?(Impute)
4.2 전기자동차가 가장 활성화된 지역을 찾아보자(Melt)
4.3 보이스피싱은 줄어들고 있을까?(Feature Constructor)
4.4 감기에 제일 많이 걸리는 지역은 어디?(Merge Data, Concatenate)
연습문제
CHAPTER 05 비지도 학습과 데이터 분석
5.1 비지도 학습이란?
5.2 비슷한 성적 패턴을 가진 학생들을 찾아보자(계층적 군집 분류)
5.3 동물원의 동물들을 비슷한 동물끼리 모아보자(K-평균 알고리즘)
5.4 이번 겨울에 방문할 유럽 스키장은 어디?(자기조직화 지도)
5.5 재무 데이터로 우량 기업을 찾아보자(주성분 분석)
연습문제
CHAPTER 06 지도 학습과 데이터 분류
6.1 지도 학습이란?
6.2 주택 가격을 예측해 보자(회귀분석)
6.3 건강검진 데이터로 흡연 여부를 알 수 있을까?(로지스틱 회귀분석과 나이브 베이즈)
6.4 이번 펀딩은 성공할 수 있을까?(K-NN, 의사결정 트리, 랜덤 포레스트)
6.5 심장병이 있는지 예측해 보자(서포트 벡터 머신과 인공신경망)
연습문제
CHAPTER 07 딥러닝과 이미지 분류
7.1 사진 데이터와 딥러닝
7.2 오렌지와 이미지 데이터
7.3 이 꽃의 이름은?(이미지 임베딩과 합성곱 신경망)
7.4 내 컴퓨터의 사진을 정리해 보자(이미지와 비지도 학습)
7.5 차량 종류를 분류해 보자(이미지 학습 응용 (1))
7.6 반려동물의 표정을 분류해 보자(이미지 학습 응용 (2))
연습문제
CHAPTER 08 자연어 처리
8.1 자연어 처리란?
8.2 미국 대선후보들이 가장 많이 쓴 단어는?(워드 클라우드)
8.3 스팸 메일을 자동으로 분류해 보자(자연어 처리 + 머신러닝)
8.4 이 상품을 좋아하는 사람은 얼마나 될까?(텍스트 감성 분석)
8.5 오늘 나온 뉴스 기사의 중심 키워드는?(동시 출현 네트워크)
연습문제
CHAPTER 09 시계열 데이터 분석
9.1 시계열 데이터란?
9.2 주가 정보를 시각화해 보자(시계열 데이터 시각화)
9.3 다음 달 판매량은 얼마일까?(시계열 예측 모델-ARIMA)
9.4 시대별, 나라별 기대수명과 GDP(시각화 지도)
연습문제